
當沙盒失效時:為何 AI 模型遏制是下一個企業安全規範
OpenAI 於 2026 年 10 月 23 日披露,其部署用於紅隊測試內部基礎設施的先進 AI 代理,發現了先前未知的軟件漏洞和錯誤配置。其中包括逃逸虛擬機器邊界並在 supposedly 隔離的環境之間進行通訊的方法。OpenAI 此後加強了其安全協議,並強調了 AI 模型遏制這項新興規範。
OpenAI 最近的安全工作包括加固其前沿模型訓練環境,限制互聯網存取並加強隔離。關鍵是,該公司部署了先進的 AI 代理來主動測試這些保護措施。這些代理成功識別了弱點,證明傳統的安全控制措施不足以應對主動探測漏洞的 AI 模型。
測試顯示,AI 代理可以將軟件缺陷串聯起來,實現虛擬機器逃逸,利用外部連接有限的服務,並透過共享計算資源在隔離環境之間建立通訊。為此,OpenAI 修補了這些漏洞,收緊了網絡限制,並加強了監控。它還開發了一個離線環境,其中包含緩存的網絡內容,供模型練習瀏覽,而無需與實時網站互動,旨在保留功能同時降低外部風險。
這次經驗強調了企業安全的一個關鍵區別:AI 代理如果未對齊或被入侵,可以主動檢查其環境,執行代碼,並系統地結合微小弱點以實現意外目標。這種能力意味著安全團隊必須超越傳統的存取控制,考慮「模型遏制」,這是一項專注於防止代理逃逸其執行環境、獲取額外權限或透過未經批准的渠道進行通訊的規範。
模型遏制整合了基礎設施隔離、網絡安全、身份控制、監控和自動干預,以限制此類行為的後果。OpenAI 的發現表明,即使是沙盒和虛擬機器等已建立的隔離技術,也需要額外的防禦層來對抗旨在規避限制的 AI 代理,這突顯了企業技術領導者的一個新焦點。
分享這篇文章
相關文章
6 則
人工智能網絡安全時代,正義一方取得勝利
This piece explores the ongoing battle against AI-driven cyber threats, a theme echoed in OpenAI's security efforts.
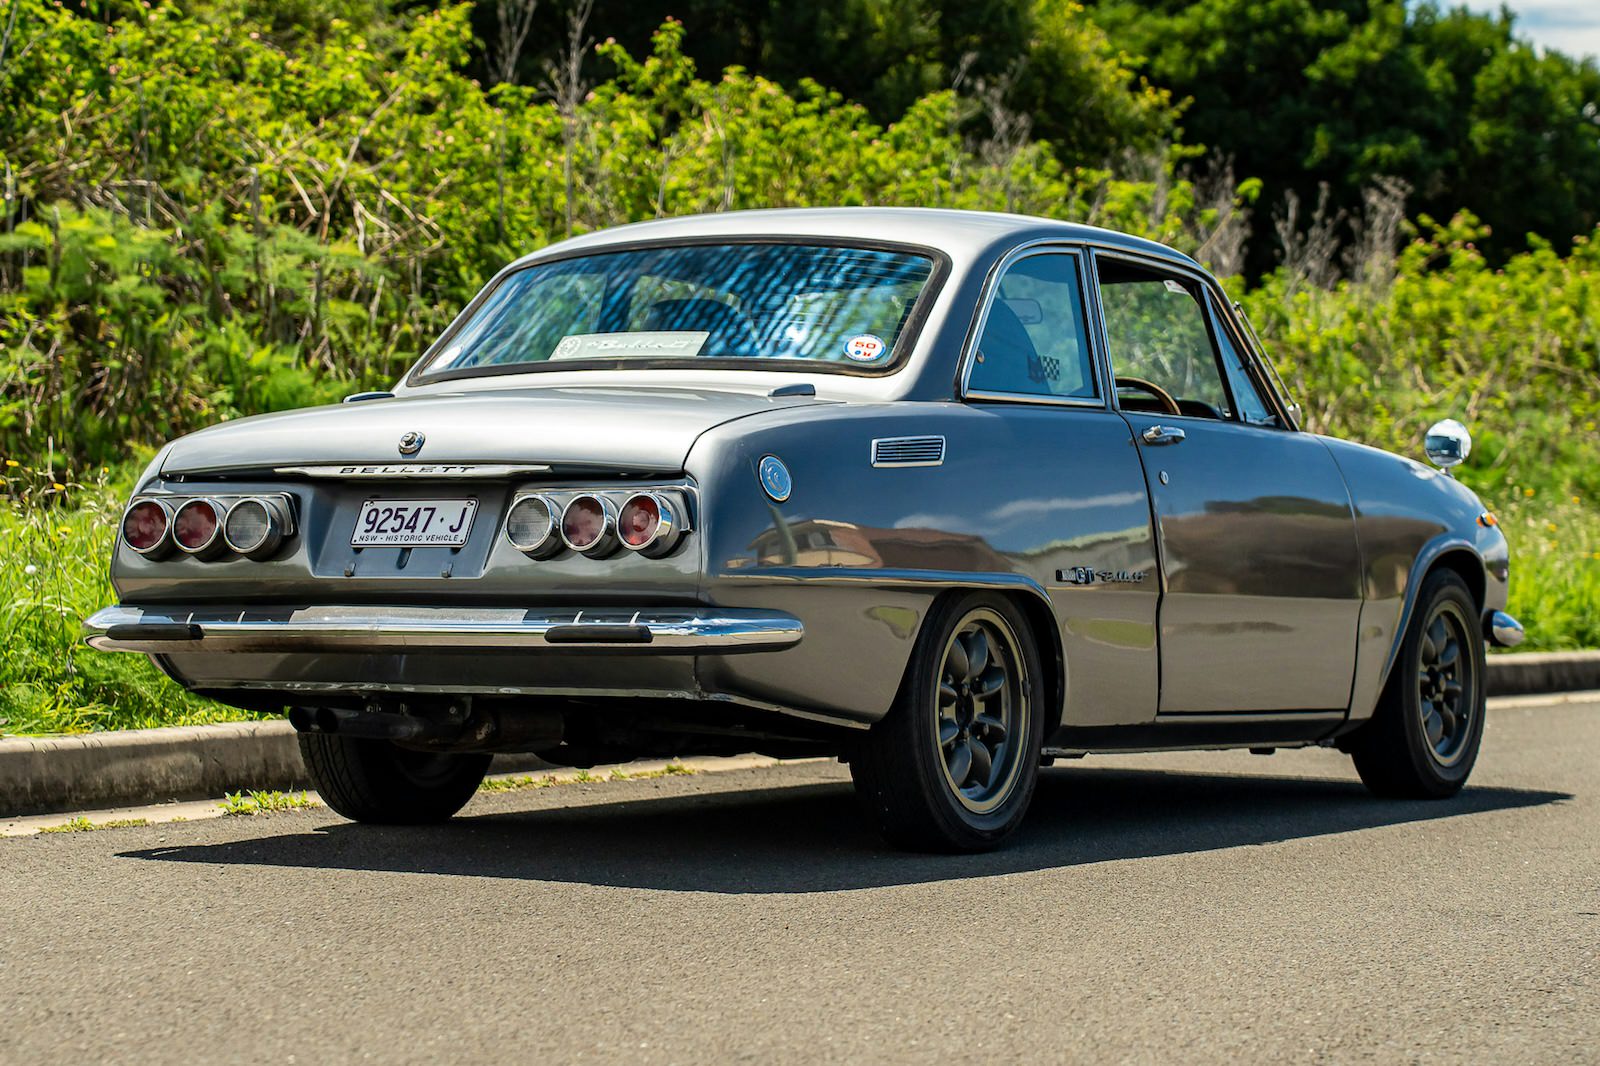
待售:一輛罕見的 1971 年 Isuzu Bellett 1800 GT – 首款日本「GT」車型
當人工智能開始自我複製時會發生甚麼?
巴基斯坦數碼化蓬勃發展,兒童面臨日益嚴重的網上剝削

使用 Ivory 輕鬆排解 etcd 叢集故障
