DualEntry基準測試發現:開源AI模型在會計工作上正追趕閉源模型
根據DualEntry會計AI基準測試,開源AI模型在專業會計任務中表現出色。Moonshot AI的Kimi K3.1 Pro獲得86.1%的準確度,排名第四,而Zhipu AI的GLM-5.3 Flash以88.1%的成績並列第二。這些結果意味著在此基準測試中,排名前四的模型中有兩個是開源的,其中領先的開源模型僅落後Google的Gemini 4 Argon 3.0分。
DualEntry會計AI基準測試是一項針對AI模型在會計任務上的測試,結果顯示開源模型正達到與專有產品相當,甚至在某些情況下超越其性能的水平。Moonshot AI的Kimi K3.1 Pro作為一個開源模型,得分86.1%,排名第四,超越了Anthropic、OpenAI和Meta的所有模型。另一個開源模型Zhipu AI的GLM-5.3 Flash以88.1%的成績並列第二。
這些發現表明,對於會計等特定業務功能,開源和閉源AI模型之間的選擇不再是關於明確的性能等級。儘管Google的Gemini 4 Argon以91.1%領先基準測試,但表現最佳的開源模型僅落後3.0分。這一微小差距意味著其他因素,如部署靈活性、數據控制或整合成本,可能會越來越多地影響企業在考慮AI解決方案時的採用決策。
Moonshot AI和Zhipu AI模型(兩者均來自亞洲)的競爭性表現,突顯了該地區AI發展格局中日益增長的能力。它們在專業基準測試中對抗老牌全球參與者的強勁表現表明,開源貢獻不僅僅是跟上步伐,而且正成為複雜企業應用中可行且高性能的選擇。這一趨勢可能會促進會計技術領域更大的創新和客製化。
分享這篇文章
相關文章
6 則
企業人工智能為何從通用大型語言模型轉向特定領域模型?
We explored why enterprises are moving beyond generic LLMs to domain-specific models, a trend echoed by open-source accounting AI.
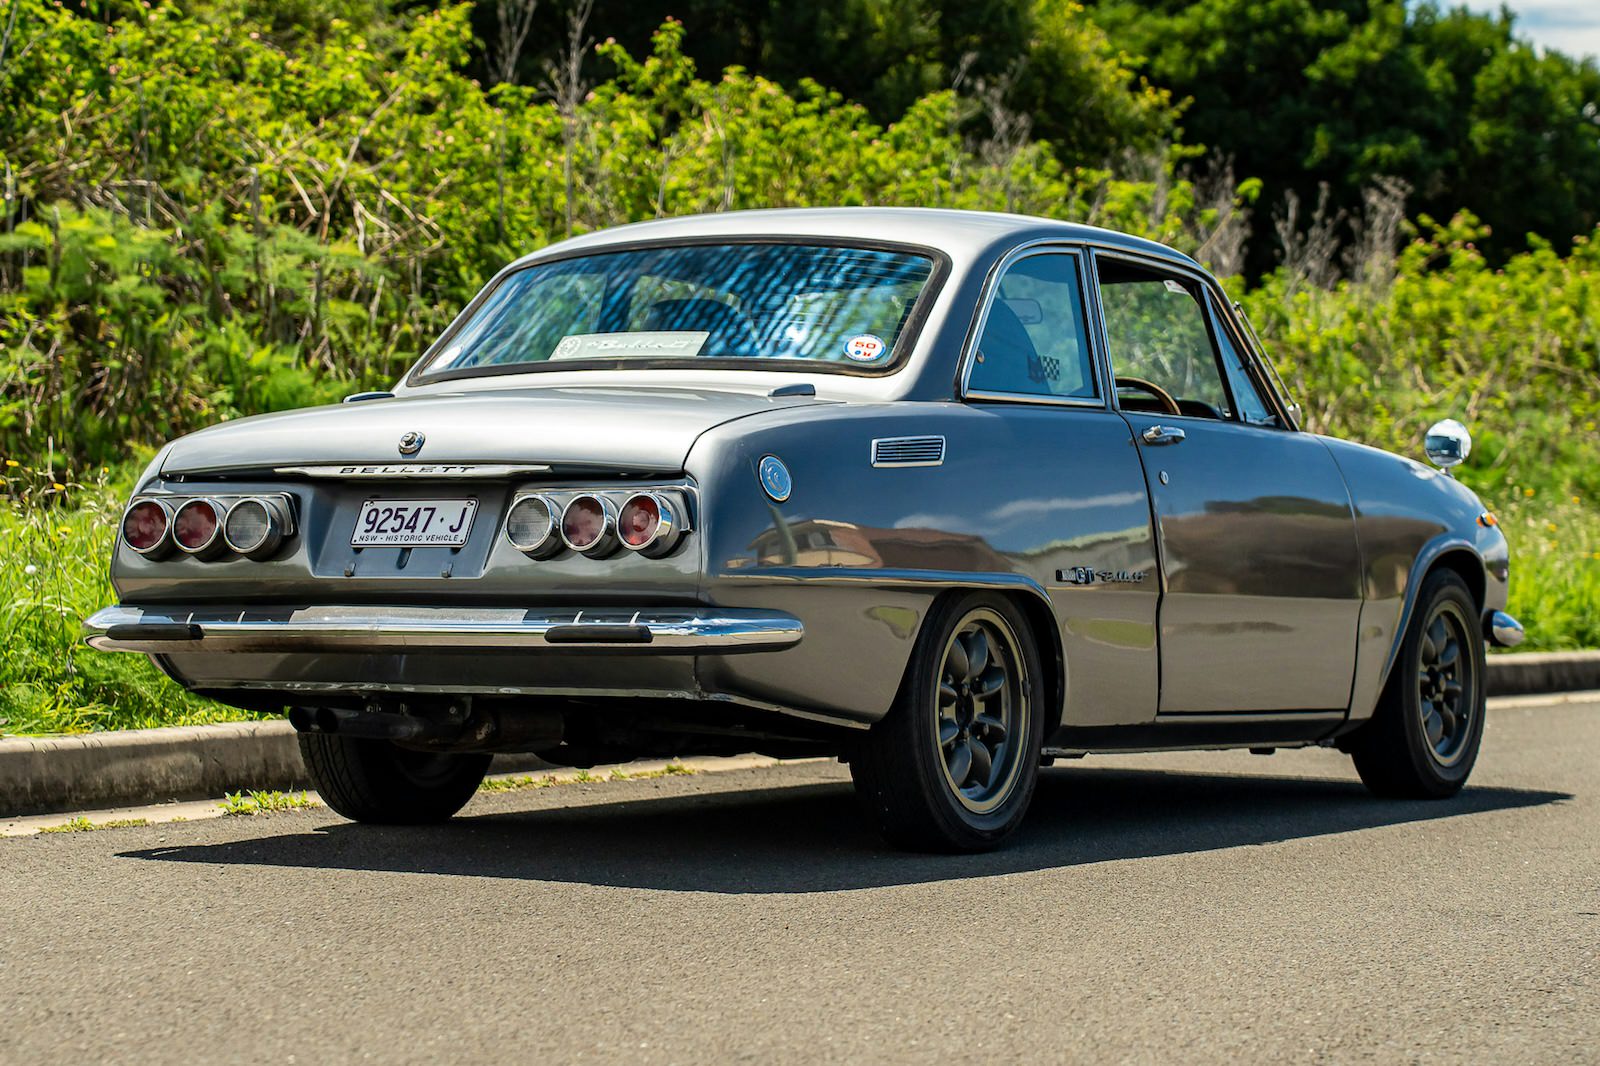
待售:一輛罕見的 1971 年 Isuzu Bellett 1800 GT – 首款日本「GT」車型
當人工智能開始自我複製時會發生甚麼?

使用 Ivory 輕鬆排解 etcd 叢集故障

我的第一個 cognee 連接器:將 Basecamp 同步到 AI 代理的記憶中