
選擇合適的LLM(大型語言模型)
沒有單一的「最佳」人工智能。學習六點框架,為工作挑選合適的模型——以及如何解讀每個實驗室的下一步發展方向。
專為小螢幕而設,以精簡卡片及快速測試代替長篇捲動。
體驗互動模式迷思:「告訴我哪個是最好的就行了」
每個人都問同一個問題:哪個人工智能是最好的?
現實檢視:沒有最好的。即使你問了,每個月你都會得到不同的答案——因為排名確實每個月都在重新洗牌。
更好的問題不是「哪個最好」。而是「最適合什麼?」這需要一個真正的框架,而不是憑直覺。
每次都值得檢查的六件事:
- 優勢與常見用例 — 它實際上擅長什麼?
- 成本 — 免費、固定訂閱還是按使用量付費?
- 語氣 — 它的語氣是否符合你想要的?
- 知識截止日期與即時存取 — 它知道這週的資訊,還是只知道去年的?
- 在亞洲的易用性 — 你是否真的可以存取它,而無需變通方法?
- 通用型與專用型 — 它是通才,還是為單一任務而建?
將任何工具透過這六個標準進行評估,「哪個最好」就會變成一個你可以實際使用的答案。
通用型陣容
目前有五個實驗室定義了通用型類別。不是版本——是實驗室。版本號每月都在變;每個實驗室的用途變化則慢得多。
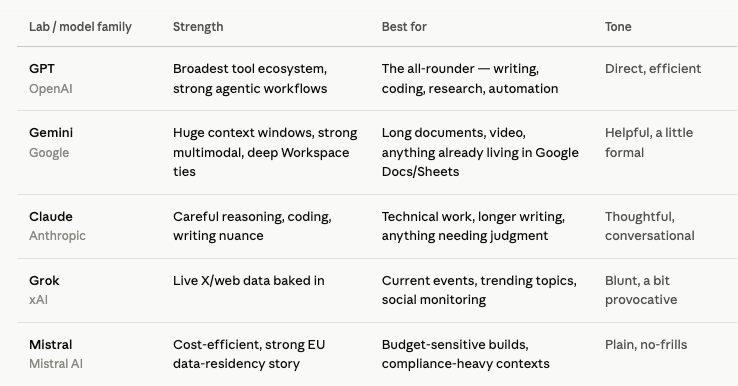
此表格中故意未列出:Perplexity 和 Poe。兩者都沒有訓練自己的前沿模型——它們都是建立在上述實驗室的基礎之上。它們屬於下一節。
API 與您已知的應用程式
對於絕大多數人來說,應用程式已足夠。ChatGPT、Claude、Gemini — 打開應用程式,輸入文字,完成。無需設定,每月固定費用,無需配置任何東西。
當您要建構某些東西時,API 就很重要。自動化任務、為工具提供動力、從您自己的程式碼呼叫模型 — 這時您會選擇 API 存取,而不是聊天視窗。按使用量付費,而非固定費用。通常不是初學者首先需要的東西。
聚合器介於兩者之間。有兩個值得了解:
- Poe — 一個訂閱,在一個地方整合了來自不同實驗室的多個模型。對於並排比較模型而無需五個獨立帳戶非常有用。缺點:您會失去每個實驗室在其自己的應用程式中建構的深度工具整合。
- Perplexity — 專為搜尋和引用答案而建構,而非一般對話。它運行在其他實驗室的模型(或其自己的較小型模型)之上,而不是訓練自己的前沿模型。當您需要有來源、最新的帶引用的答案時,請選擇它 — 而不是將其作為一般助理的替代品。
面向開發者的注意事項:OpenRouter 扮演的角色與 Poe 相同,但適用於 API 存取而非聊天。
中國問題,直截了當處理
以下是坦誠直白的假設:美國實驗室目前領先。中國正迅速縮小差距。這句話的兩部分都是事實,而且彼此不互相抵消。
中國模型真正站得住腳的理由不是炒作,而是算術:
- DeepSeek — 開源模型,在編碼、數學和推理基準測試中,其表現經常與頂尖的美國模型相差無幾,但成本卻低得多。
- Qwen (Alibaba) — 大型開源模型,具備強大的多模態和代理能力。
- GLM (Zhipu / Z.ai) — 專家混合架構,在多個開源排行榜上名列前茅,以寬鬆許可證發布。
價格便宜,在許多任務上表現相符。這是實際的說法,而且數據也支持這一點。
它沒有自動解決的問題:數據駐留(您的輸入實際上去了哪裡?)、對政治敏感內容的處理,以及「接近前沿」並非「前沿」在最困難的推理任務上的事實。請根據您的實際用例權衡這些因素 — 大量草稿和編碼傾向於「節省是真實的」;任何涉及敏感公司數據或政治敏感內容的,則需要更加謹慎。
最重要的注意事項是:當您讀到這篇文章時,今天的排名可能已經改變。三個主要的開源發布可以在一個季度內重新洗牌排行榜。不要執著於本週的數字 — 執著於模式。
價值重於版本號
以下是值得記住的模式:每個實驗室的方向比本週的基準測試更能說明問題。
- OpenAI — 快速行動、全面推出、最廣泛的工具生態系統。
- Anthropic — 安全至上、推理深度、嚴謹寫作。
- Google — 生態系統整合、多模態規模、萬物互聯。
- xAI — 速度、實時數據、刻意較少過濾的語氣。
- Mistral — 開放效率、符合法規的選項。
- Chinese labs — 將成本民主化作為明確策略,將開放權重作為交付方式。
為什麼這比聽起來更重要:實驗室的方向預測其下一步行動 — 新技能、插件、代理工具、整合 — 遠早於任何單一版本。一個追求工具生態系統的實驗室將會不斷推出插件。一個追求安全的實驗室將會不斷推出防護措施和更慢、更審慎的版本。一個追求成本的實驗室將會不斷壓低價格。
這是在深入構建一個生態系統之前需要了解的事情。將您的工作流程與一個實驗室的特定工具緊密結合,比今天選擇一個聊天應用程式是更大的承諾 — 首先要了解其方向。
接下來該嘗試什麼
從不同行中選擇兩到三個模型。一個您最喜歡的通用模型,一個來自完全不同實驗室的模型,如果成本是您真正考慮的因素,或許可以選擇一個中國開源模型。
將您實際的一項工作透過每個模型執行一次。不是一個玩具問題——而是您正要撰寫的電郵、正要偵錯的程式碼,或是您今天需要的摘要。
保留您實際會再次信任其執行該任務的模型。
確切的模型重要嗎?對於大多數日常工作而言——其重要性比人們想像的要低。差異最明顯地體現在邊緣情況:實際規模下的成本、即時/最新數據、特定的基準測試任務、數據駐留。對於日常的寫作、起草或快速研究,其中幾種工具都能同樣出色地為您服務。本課程的框架並非旨在尋找一個普遍的贏家——而是為了讓您知道自己實際正在優化哪種邊緣情況,並據此做出選擇。
Nexa 的結論:這個類別既真正成熟又同時快速發展。這個框架比任何單一模型都更持久——這才是這裡真正值得記住的。
您現在學到的知識
- 沒有單一的「最佳」大型語言模型 — 應從效能、成本、語氣、知識時效性、存取方式,以及通用型與專用型等方面進行比較。
- GPT、Gemini、Claude、Grok 和 Mistral 各有獨特優勢 — 應根據任務選擇,而非品牌忠誠度。
- 使用您自己的實際工作測試 2–3 個工具。保留您信任的那個。
- Perplexity 和 Poe 是建基於其他實驗室模型之上的應用程式層,而非新的基礎模型 — 應將它們用於搜尋和引用或並排比較,而非作為您的主要助手。
- 中國模型(DeepSeek、Qwen、GLM)確實能以極低的成本提供接近前沿的效能 — 雖然存在實際的權衡,但成本效益是事實,而非炒作。
- 追蹤每個實驗室的發展方向,而不僅僅是今天的排行榜 — 這能讓您在下一個版本發佈之前,了解即將推出的內容。