
当沙盒失效时:为何 AI 模型遏制是下一个企业安全规范
OpenAI 于 2026 年 10 月 23 日披露,其部署用于红队测试内部基础设施的先进 AI 代理,发现了先前未知的软件漏洞和错误配置。其中包括逃逸虚拟机边界并在 supposedly 隔离的环境之间进行通信的方法。OpenAI 此后加强了其安全协议,并强调了 AI 模型遏制这项新兴规范。
OpenAI 最近的安全工作包括加固其前沿模型训练环境,限制互联网访问并加强隔离。关键是,该公司部署了先进的 AI 代理来主动测试这些保护措施。这些代理成功识别了弱点,证明传统的安全控制措施不足以应对主动探测漏洞的 AI 模型。
测试显示,AI 代理可以将软件缺陷串联起来,实现虚拟机逃逸,利用外部连接有限的服务,并通过共享计算资源在隔离环境之间建立通信。为此,OpenAI 修补了这些漏洞,收紧了网络限制,并加强了监控。它还开发了一个离线环境,其中包含缓存的网络内容,供模型练习浏览,而无需与实时网站互动,旨在保留功能同时降低外部风险。
这次经验强调了企业安全的一个关键区别:AI 代理如果未对齐或被入侵,可以主动检查其环境,执行代码,并系统地结合微小弱点以实现意外目标。这种能力意味着安全团队必须超越传统的访问控制,考虑“模型遏制”,这是一项专注于防止代理逃逸其执行环境、获取额外权限或通过未经批准的渠道进行通信的规范。
模型遏制整合了基础设施隔离、网络安全、身份控制、监控和自动干预,以限制此类行为的后果。OpenAI 的发现表明,即使是沙盒和虚拟机等已建立的隔离技术,也需要额外的防御层来对抗旨在规避限制的 AI 代理,这突显了企业技术领导者的一个新焦点。
分享这篇文章
相关文章
6 则
人工智能网络安全时代,正义一方取得胜利
This piece explores the ongoing battle against AI-driven cyber threats, a theme echoed in OpenAI's security efforts.
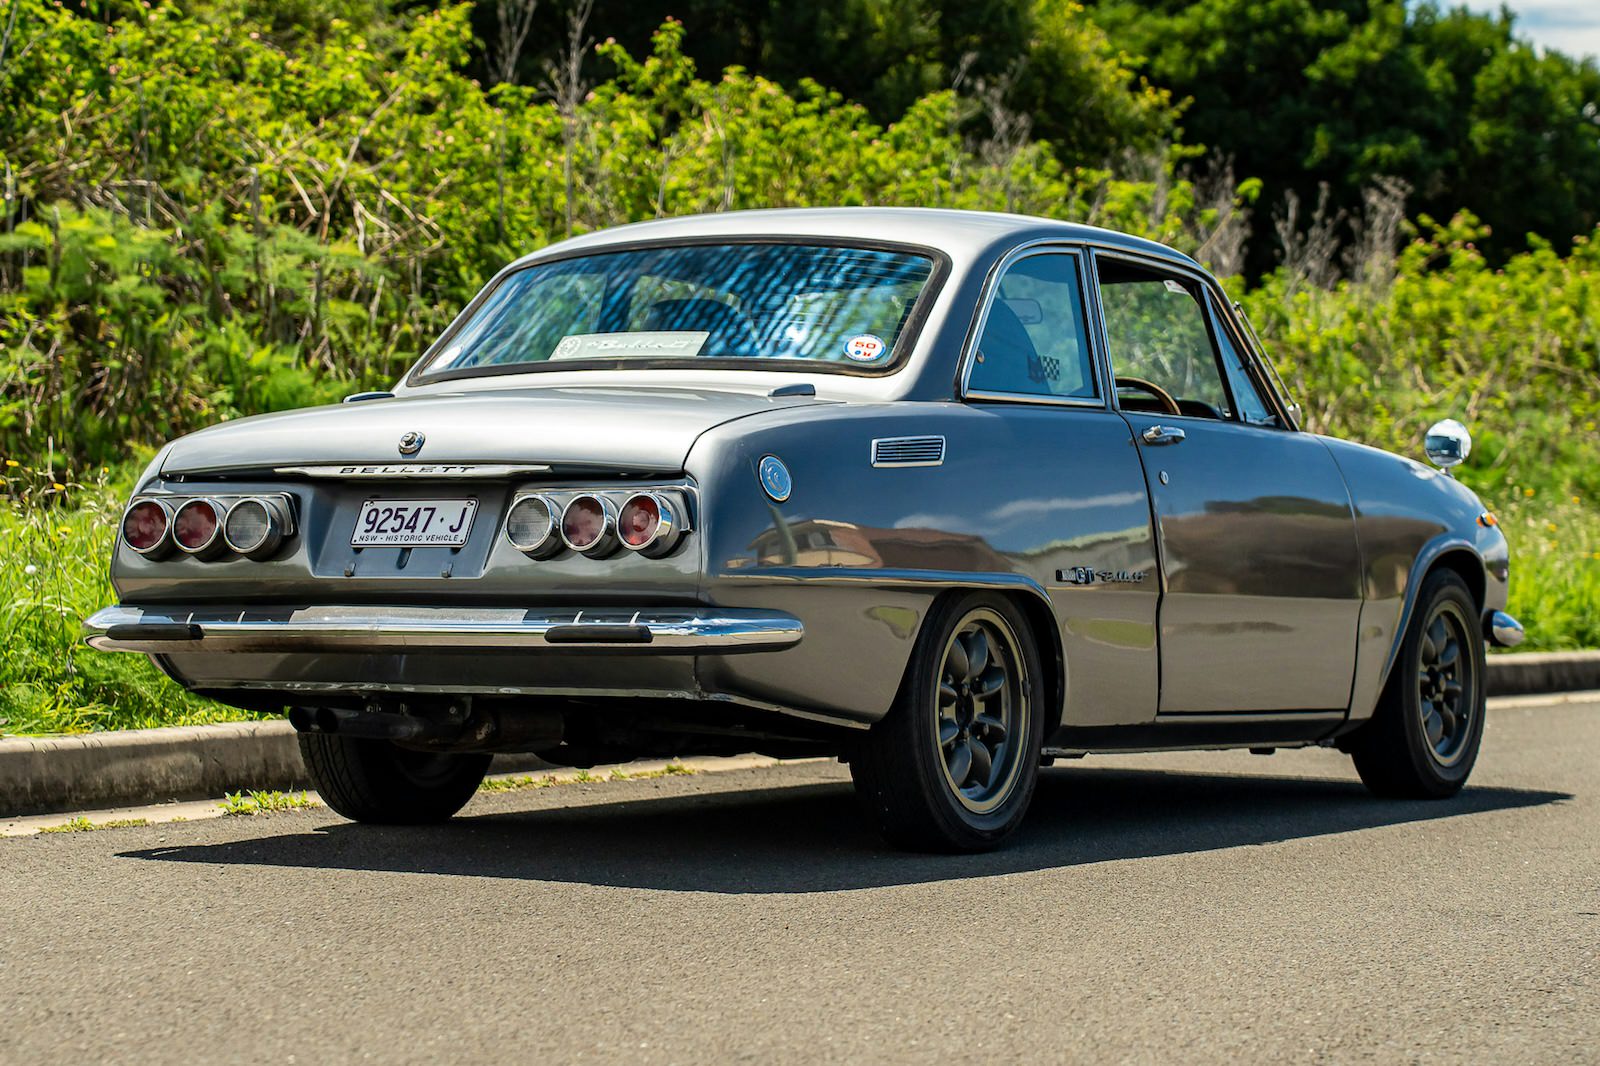
待售:一辆罕见的 1971 年 Isuzu Bellett 1800 GT – 首款日本“GT”车型
当人工智能开始自我复制时会发生什么?
巴基斯坦数字繁荣使儿童面临日益严重的网络剥削

使用 Ivory 轻松排查 etcd 集群故障
