
🇭🇰香港·AI 新闻·2026年10月31日·来源: The Standard 英文虎報
AI巨头承诺为出版商提供新方法以阻止部分内容抓取
OpenAI、Google、Microsoft 和 Anthropic 已承诺向媒体机构提供一个单一、标准化的方法,以防止其内容被抓取用于训练人工智能模型。这项举措旨在简化出版商管理其知识产权的方式,解决目前需要为不同网络爬虫设置多个阻止指令的现有挑战。
拟议的解决方案引入了一项统一指令,一旦采用,将会得到参与的AI公司的认可,从而简化出版商选择退出AI训练内容抓取的流程。这与目前分散的方法形成对比,后者导致出版商的批评和法律行动增多,其中包括《The New York Times》对OpenAI和Microsoft提起诉讼,指控其未经授权使用其文章。
然而,这项新标准的实际影响不会立竿见影。Microsoft计划于2027年2月1日开始实施该解决方案,Google则将“在2027年的某个时候”跟进。OpenAI预计将在“未来几个月内”推出,而Anthropic则表示已“开始实施”。这种分阶段的实施意味着行业内广泛、统一的效果仍需数月才能实现。
新设置的范围也具体:它仅适用于未来AI模型的训练,并不阻止一般的网络爬虫。在出版商主动更改其设置之前,内容抓取仍将是默认选项。Microsoft和Google还指出,选择退出可能会降低出版商内容在AI应用和体验中出现的几率,这对内容提供商来说可能是一个权衡。
分享这篇文章
原文报道: The Standard 英文虎報我们不转载全文, 阅读原文 →
相关文章
6 则
AI 新闻
Google、Microsoft、OpenAI 和 Anthropic 支持单一 AI 训练退出选项
We previously reported on the same major AI players backing a unified opt-out standard for content scraping.
🇯🇵·AI 新闻
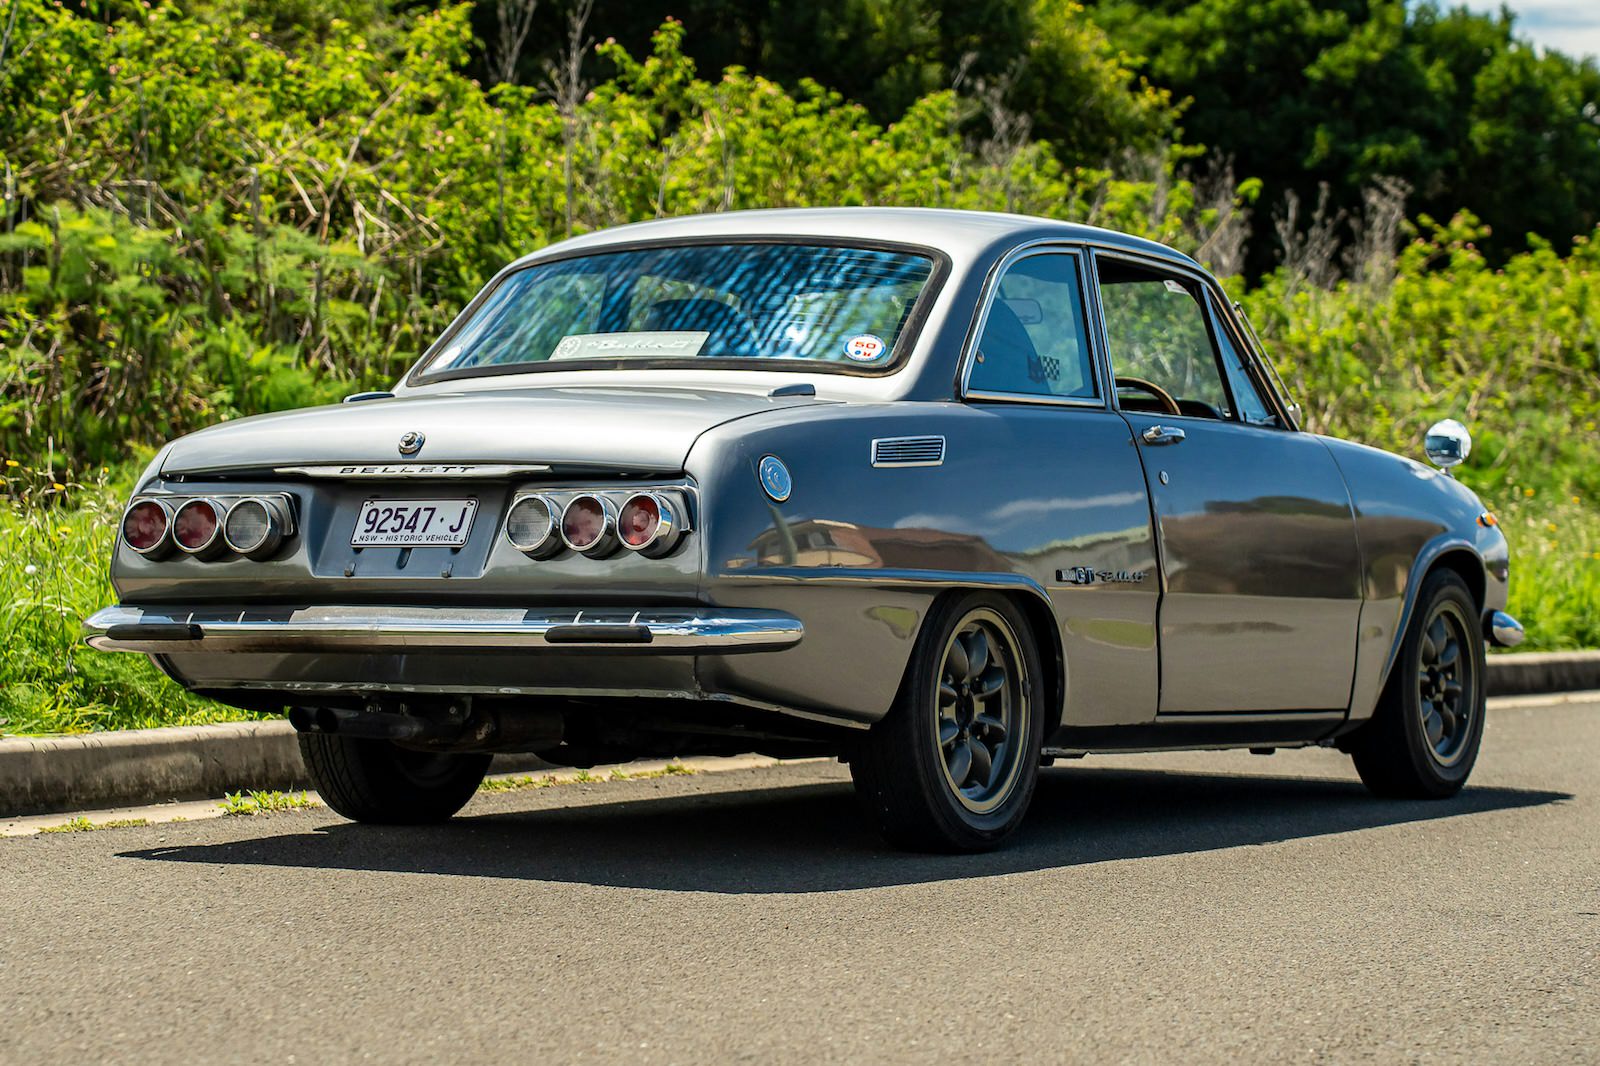
待售:一辆罕见的 1971 年 Isuzu Bellett 1800 GT – 首款日本“GT”车型
🇸🇬·AI 新闻
当人工智能开始自我复制时会发生什么?

AI 新闻
使用 Ivory 轻松排查 etcd 集群故障

AI 新闻
我的第一个 cognee 连接器:将 Basecamp 同步到 AI 代理的内存中

AI 新闻