选择合适的LLM(大型语言模型)
没有单一的“最佳”人工智能。学习六点框架,为工作挑选合适的模型——以及如何解读每个实验室的下一步发展方向。
专为小屏幕设计,以精简卡片和快速测试代替长篇滚动。
体验互动模式迷思:“告诉我哪个是最好的就行了”
每个人都问同一个问题:哪个人工智能是最好的?
现实检验:没有最好的。即使你问了,每个月你都会得到不同的答案——因为排名确实每个月都在重新洗牌。
更好的问题不是“哪个最好”。而是“最适合什么?”这需要一个真正的框架,而不是凭直觉。
每次都值得检查的六件事:
- 优势与常见用例 — 它实际上擅长什么?
- 成本 — 免费、固定订阅还是按使用量付费?
- 语气 — 它的语气是否符合你想要的?
- 知识截止日期与实时访问 — 它知道这周的信息,还是只知道去年的?
- 在亚洲的易用性 — 你是否真的可以访问它,而无需变通方法?
- 通用型与专用型 — 它是通才,还是为单一任务而建?
将任何工具通过这六个标准进行评估,“哪个最好”就会变成一个你可以实际使用的答案。
通用型阵容
目前有五个实验室定义了通用型类别。不是版本——是实验室。版本号每月都在变;每个实验室的用途变化则慢得多。
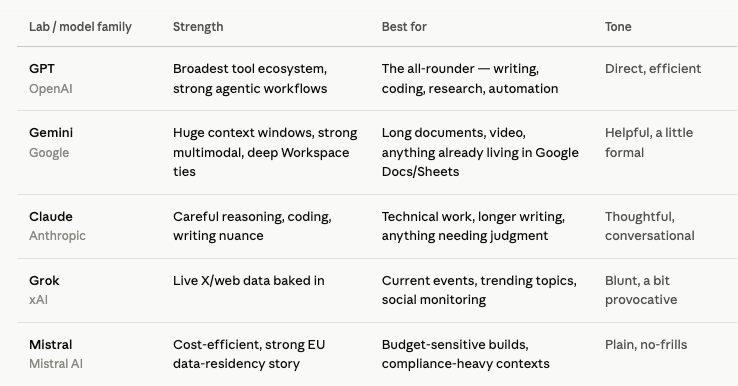
此表格中故意未列出:Perplexity 和 Poe。两者都没有训练自己的前沿模型——它们都是建立在上述实验室的基础之上。它们属于下一节。
API 与您已知的应用程序
对于绝大多数人来说,应用程序已足够。ChatGPT、Claude、Gemini — 打开应用程序,输入文字,完成。无需设置,每月固定费用,无需配置任何东西。
当您要构建某些东西时,API 就很重要。自动化任务、为工具提供动力、从您自己的代码调用模型 — 这时您会选择 API 访问,而不是聊天窗口。按使用量付费,而非固定费用。通常不是初学者首先需要的东西。
聚合器介于两者之间。有两个值得了解:
- Poe — 一个订阅,在一个地方整合了来自不同实验室的多个模型。对于并排比较模型而无需五个独立账户非常有用。缺点:您会失去每个实验室在其自己的应用程序中构建的深度工具集成。
- Perplexity — 专为搜索和引用答案而构建,而非一般对话。它运行在其他实验室的模型(或其自己的较小型模型)之上,而不是训练自己的前沿模型。当您需要有来源、最新的带引用的答案时,请选择它 — 而不是将其作为一般助理的替代品。
面向开发者的注意事项:OpenRouter 扮演的角色与 Poe 相同,但适用于 API 访问而非聊天。
中国问题,直截了当处理
以下是坦诚直白的假设:美国实验室目前领先。中国正迅速缩小差距。这句话的两部分都是事实,而且彼此不互相抵消。
中国模型真正站得住脚的理由不是炒作,而是算术:
- DeepSeek — 开源模型,在编码、数学和推理基准测试中,其表现经常与顶尖的美国模型相差无几,但成本却低得多。
- Qwen (Alibaba) — 大型开源模型,具备强大的多模态和代理能力。
- GLM (Zhipu / Z.ai) — 专家混合架构,在多个开源排行榜上名列前茅,以宽松许可证发布。
价格便宜,在许多任务上表现相符。这是实际的说法,而且数据也支持这一点。
它没有自动解决的问题:数据驻留(您的输入实际上去了哪里?)、对政治敏感内容的处理,以及“接近前沿”并非“前沿”在最困难的推理任务上的事实。请根据您的实际用例权衡这些因素 — 大量草稿和编码倾向于“节省是真实的”;任何涉及敏感公司数据或政治敏感内容的,则需要更加谨慎。
最重要的注意事项是:当您读到这篇文章时,今天的排名可能已经改变。三个主要的开源发布可以在一个季度内重新洗牌排行榜。不要执着于本周的数字 — 执着于模式。
价值重于版本号
以下是值得记住的模式:每个实验室的方向比本周的基准测试更能说明问题。
- OpenAI — 快速行动、全面推出、最广泛的工具生态系统。
- Anthropic — 安全至上、推理深度、严谨写作。
- Google — 生态系统集成、多模态规模、万物互联。
- xAI — 速度、实时数据、刻意较少过滤的语气。
- Mistral — 开放效率、合规友好的选项。
- Chinese labs — 将成本民主化作为明确策略,将开放权重作为交付方式。
为什么这比听起来更重要:实验室的方向预测其下一步行动 — 新技能、插件、代理工具、集成 — 远早于任何单一版本。一个追求工具生态系统的实验室将会不断推出插件。一个追求安全的实验室将会不断推出防护措施和更慢、更审慎的版本。一个追求成本的实验室将会不断压低价格。
这是在深入构建一个生态系统之前需要了解的事情。将您的工作流程与一个实验室的特定工具紧密结合,比今天选择一个聊天应用程序是更大的承诺 — 首先要了解其方向。
接下来该尝试什么
从不同行中选择两到三个模型。一个您最喜欢的通用模型,一个来自完全不同实验室的模型,如果成本是您真正考虑的因素,或许可以选择一个中国开源模型。
将您实际的一项工作通过每个模型运行一次。不是一个玩具问题——而是您正要撰写的电子邮件、正要调试的代码,或是您今天需要的摘要。
保留您实际会再次信任其执行该任务的模型。
确切的模型重要吗?对于大多数日常工作而言——其重要性比人们想象的要低。差异最明显地体现在边缘情况:实际规模下的成本、实时/最新数据、特定的基准测试任务、数据驻留。对于日常的写作、起草或快速研究,其中几种工具都能同样出色地为您服务。本课程的框架并非旨在寻找一个普遍的赢家——而是为了让您知道自己实际正在优化哪种边缘情况,并据此做出选择。
Nexa 的结论:这个类别既真正成熟又同时快速发展。这个框架比任何单一模型都更持久——这才是这里真正值得记住的。
您现在学到的知识
- 没有单一的“最佳”大型语言模型 — 应从性能、成本、语气、知识时效性、访问方式,以及通用型与专用型等方面进行比较。
- GPT、Gemini、Claude、Grok 和 Mistral 各有独特优势 — 应根据任务选择,而非品牌忠诚度。
- 使用您自己的实际工作测试 2–3 个工具。保留您信任的那个。
- Perplexity 和 Poe 是建立在其他实验室模型之上的应用程序层,而非新的基础模型 — 应将它们用于搜索和引用或并排比较,而非作为您的主要助手。
- 中国模型(DeepSeek、Qwen、GLM)确实能以极低的成本提供接近前沿的性能 — 虽然存在实际的权衡,但成本效益是事实,而非炒作。
- 追踪每个实验室的发展方向,而不只是今天的排行榜 — 这能让您在下一个版本发布之前,了解即将推出的内容。