
🇭🇰香港·AI 新聞·2026年10月31日·來源: The Standard 英文虎報
AI巨頭承諾為出版商提供新方法以阻止部分內容抓取
OpenAI、Google、Microsoft 和 Anthropic 已承諾向媒體機構提供一個單一、標準化的方法,以防止其內容被抓取用於訓練人工智能模型。這項舉措旨在簡化出版商管理其知識產權的方式,解決目前需要為不同網絡爬蟲設置多個阻止指令的現有挑戰。
擬議的解決方案引入了一項統一指令,一旦採用,將會得到參與的AI公司的認可,從而簡化出版商選擇退出AI訓練內容抓取的流程。這與目前分散的方法形成對比,後者導致出版商的批評和法律行動增多,其中包括《The New York Times》對OpenAI和Microsoft提起訴訟,指控其未經授權使用其文章。
然而,這項新標準的實際影響不會立竿見影。Microsoft計劃於2027年2月1日開始實施該解決方案,Google則將「在2027年的某個時候」跟進。OpenAI預計將在「未來幾個月內」推出,而Anthropic則表示已「開始實施」。這種分階段的實施意味著行業內廣泛、統一的效果仍需數月才能實現。
新設置的範圍也具體:它僅適用於未來AI模型的訓練,並不阻止一般的網絡爬蟲。在出版商主動更改其設置之前,內容抓取仍將是預設選項。Microsoft和Google還指出,選擇退出可能會降低出版商內容在AI應用和體驗中出現的機會,這對內容提供商來說可能是一個權衡。
分享這篇文章
原文報道: The Standard 英文虎報我們不轉載全文, 閱讀原文 →
相關文章
6 則
AI 新聞
Google、Microsoft、OpenAI 和 Anthropic 支持單一 AI 訓練退出選項
We previously reported on the same major AI players backing a unified opt-out standard for content scraping.
🇯🇵·AI 新聞
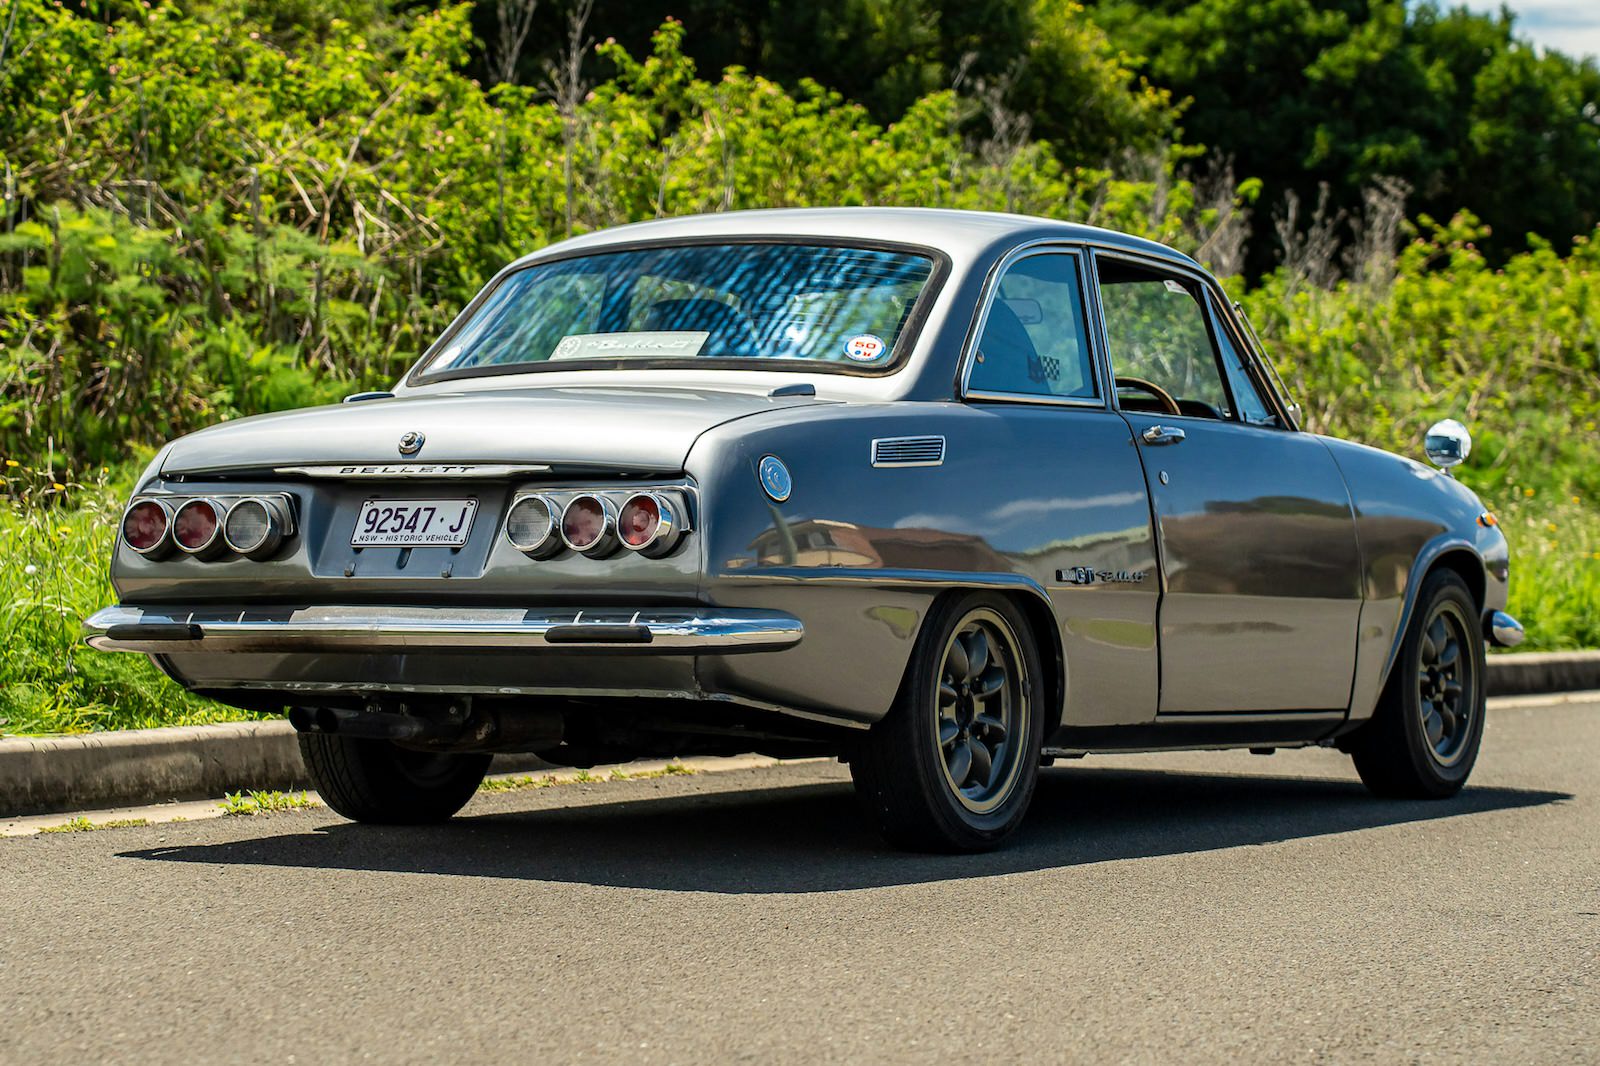
待售:一輛罕見的 1971 年 Isuzu Bellett 1800 GT – 首款日本「GT」車型
🇸🇬·AI 新聞
當人工智能開始自我複製時會發生甚麼?

AI 新聞
使用 Ivory 輕鬆排解 etcd 叢集故障

AI 新聞
我的第一個 cognee 連接器:將 Basecamp 同步到 AI 代理的記憶中

AI 新聞